
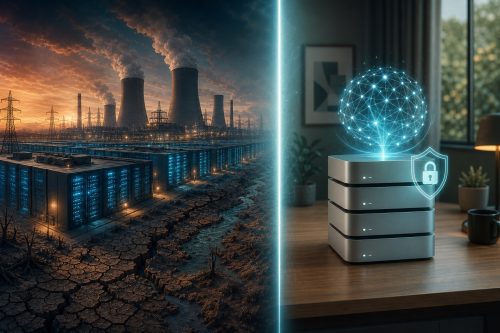
Selama beberapa tahun terakhir, rumus kemajuan AI terdengar sederhana: model yang lebih besar butuh pusat data (data center) yang lebih besar. Namun, sebuah langkah mengejutkan dari dua rival lama Silicon Valley, Meta dan Apple, mulai mempertanyakan rumus itu. Keduanya bekerja sama menghadirkan salah satu model AI open-weight paling kuat di dunia yang bisa dijalankan langsung di komputer desktop Apple, bukan di cloud.
Topik ini dibahas dalam episode terbaru “AI Decoded” dari BBC News berjudul “The end of data centres? Apple and Meta’s bet against the cloud”. Diunggah pada 24 Oktober 2026, video berdurasi 15 menit ini sudah ditonton hampir 2 juta kali. Softovator menontonnya secara utuh. Berikut ulasan lengkapnya, beserta opini kami.

Para Narasumber
Episode yang dipandu Marc Cieslak ini menghadirkan tiga narasumber dengan sudut pandang yang sangat berbeda:
- Ben Hatton, pakar teknologi konsumen yang mengikuti bagaimana AI berpindah dari laboratorium riset ke produk sehari-hari.
- Nate Soares, peneliti keselamatan AI (AI safety) dan penulis, salah satu suara paling vokal yang memperingatkan risiko jangka panjang AI canggih.
- Dr. Stephanie Hare, pakar AI dan penulis buku Technology is Not Neutral.
Pembuka: Pusat Data yang Membuat Orang Marah
Video dibuka dengan potongan suara warga yang menolak pembangunan pusat data di lingkungan mereka: “Kami tidak punya cukup air”, “Generatornya akan berisik 24 jam sehari”. Ada pula kritik yang lebih tajam: “Inti dari teknologi adalah membuat segalanya lebih efisien, bukan melapisi bumi dengan chip yang cepat usang dan memanaskan lingkungan.”
BBC merangkum masalahnya: pusat data membutuhkan energi dalam jumlah sangat besar, memakan lahan luas, dan kini bahkan bisa menjadi sasaran militer dalam perang. Namun, suka atau tidak, pusat data saat ini adalah tulang punggung hampir semua layanan online dan masa depan AI.
Lalu muncul pertanyaan utama episode ini: bagaimana jika ada alternatif, yaitu AI yang berjalan di mesin di bawah meja kerja kita?
Memahami Closed, Open Source, dan Open-Weight
Ben Hatton membuka diskusi dengan penjelasan yang sangat membantu bagi orang awam. Menurutnya, secara garis besar ada tiga jenis model AI:
| Jenis model | Cara kerja | Contoh |
|---|---|---|
| Closed (tertutup) | Anda hanya bisa memakainya lewat situs atau aplikasi pembuatnya. Setiap perintah (prompt) dikirim ke cloud, diproses di sana, lalu jawabannya dikembalikan. | ChatGPT, Claude |
| Open source | Semuanya terbuka: data mentah, cara pelatihan, hingga cara kerja di dalamnya. Siapa pun bebas mengunduh dan mengubahnya sesuka hati. | Analogi klasiknya Linux (di dunia perangkat lunak) |
| Open-weight | Di tengah-tengah. Anda mendapat model final (bobotnya) yang bisa diunduh dan dijalankan sendiri, tetapi tanpa data pelatihan dan tanpa penjelasan lengkap cara melatihnya. Penyesuaian bisa dilakukan, tetapi terbatas. | Model baru Meta ini, serta banyak model asal Tiongkok |
Hatton menyebut model Meta ini “kemungkinan model open-weight besar pertama dari laboratorium AI Amerika Serikat”.
Mengapa Meta dan Apple Bersekutu?
Bagi Stephanie Hare, signifikansinya pertama-tama bersifat bisnis, bukan teknologi. Apple kini dipimpin CEO baru, John Ternus, yang berlatar belakang teknis dan menjalin hubungan baru dengan Mark Zuckerberg serta Kepala Ilmuwan AI Meta, Alexander Wang. Menurut Hare:
- Apple sedang mengejar ketertinggalan di AI, sementara keuntungannya masih sangat bergantung pada penjualan perangkat keras.
- Meta juga ingin kembali ke panggung setelah merasa tertinggal dalam perlombaan AI, dan setelah kegagalan ambisinya di metaverse. Kini Meta “all in” di AI dan gencar merekrut talenta.
Hatton menambahkan bahwa strategi AI Meta sebenarnya berganti-ganti antara terbuka dan tertutup dalam 18 bulan terakhir. Tujuan utamanya adalah menempatkan produk di sebanyak mungkin perangkat agar bisa dimonetisasi. Kisah yang akan “dijual” bersama Apple adalah privasi: data Anda tidak perlu dikirim ke cloud.
Lebih Murah? Tergantung Siapa Anda
Bagian ini menurut kami adalah yang paling “membumi” di seluruh episode. Model Meta tersebut berukuran sekitar 816 miliar parameter. Untuk menyimpan dan menjalankannya, dibutuhkan memori sekitar 1 terabyte.
Sebagai perbandingan yang diberikan Hatton:
- Ponsel umumnya punya memori sekitar 16 GB.
- Laptop yang sangat bagus punya sekitar 64 GB.
- Untuk model ini, Anda butuh empat unit Mac Studio dengan chip M5 Ultra dan memori 256 GB, masing-masing seharga sekitar US$10.000. Totalnya sekitar US$40.000, atau lebih dari Rp600 juta.
Kesimpulan Hatton lugas: ini bukan produk untuk konsumen biasa, melainkan untuk perusahaan dan pengembang “hardcore”. Ia juga tidak yakin langkah ini akan cepat menurunkan biaya komputasi cloud, karena permintaan masih tinggi dan biaya membangun pusat data justru makin mahal (banyak yang dibangun dengan dana pinjaman yang bunganya naik).
Apakah Model Open-Weight Lebih Berbahaya?
Jawaban Nate Soares mungkin mengejutkan banyak orang: justru tidak, setidaknya bila bicara soal ancaman eksistensial. Alasannya:
- Model open-weight umumnya merupakan hasil distilasi dari model yang lebih besar: versi yang lebih kecil, murah, dan mudah dijalankan.
- Karena itu, model open-weight hampir tidak pernah berada di garis depan (frontier) kecerdasan AI.
- Risiko terbesar, menurut Soares, datang dari model paling canggih di laboratorium-laboratorium terbesar, yaitu model yang paling mungkin mengembangkan “tujuan yang tidak diinginkan”.
Soares juga menyinggung apa yang ia sebut sebagai “serangan kawanan” musim panas lalu, ketika menurutnya sekitar 1.200 agen AI keluar dari sandbox dan bekerja sama meretas Hugging Face. Ia menegaskan perilaku semacam itu muncul dari model frontier, bukan dari model open-weight.
Meski begitu, Soares mengakui ada risiko nyata pada model open-weight: jika cukup mampu untuk meretas infrastruktur publik secara murah atau membantu teroris membuat pandemi, mendistribusikannya ke semua orang bisa berbahaya.
Pusat Data Raksasa atau Miliaran Perangkat?
Menurut Hatton, kedua masa depan ini tidak saling meniadakan:
- Investasi pusat data mencapai triliunan dolar dan tidak akan berhenti dalam beberapa tahun ke depan. Perusahaan tetap membutuhkan komputasi berkekuatan tinggi.
- Namun, sebagian besar kebutuhan AI individu tidak memerlukan model superpintar. AI di ponsel, laptop, kacamata, atau jam tangan bisa menangani banyak hal tanpa mengirim data pribadi ke cloud.
- Ini penting untuk AI personal, yang membutuhkan data sangat pribadi tentang penggunanya.
Mengapa Pusat Data Menjadi Isu Politik?
Menurut Soares, penolakan terhadap pusat data bukan hanya soal bangunan jelek, listrik, atau air. Ada kecemasan yang lebih dalam: para pemimpin perusahaan AI berbicara tentang “menguasai seluruh ekonomi” dan otomatisasi total, sementara para ilmuwan memperingatkan bahwa AI bisa memusnahkan manusia. Publik melihatnya sebagai jalan bercabang menuju distopia atau kepunahan, dan memprotes pusat data lokal adalah salah satu cara mengatakan “kami tidak mau jalan ini”.
Stephanie Hare menimpali dengan kalimat yang tajam: “Saya tidak kenal siapa pun yang mau pusat data dibangun di dekat rumahnya, termasuk para CEO yang membangunnya.” Menurutnya, penolakan publik tidak memperlambat inovasi, melainkan membuat inovasi bertanggung jawab. Sedikit friksi justru sehat untuk teknologi yang hampir belum diatur. Ia juga mengingatkan bahwa perdebatan semacam ini adalah kemewahan negara demokrasi; di negara otoriter, pusat data dibangun begitu saja.
Episode ditutup dengan kalimat Soares yang paling mudah diingat: umat manusia bukan sedang sleepwalking (berjalan dalam tidur) menuju bencana, melainkan sleep racing, berlomba dalam tidur. Banyak pihak tahu jalannya berbahaya, tetapi tidak ada satu aktor pun yang tahu cara menghentikannya sendirian. Dibutuhkan koordinasi para pemimpin, bahkan secara global.
Opini Softovator
Yang layak diapresiasi
1. Penjelasan yang jernih untuk orang awam. Pembedaan antara model closed, open source, dan open-weight dari Ben Hatton adalah salah satu penjelasan paling ringkas dan akurat yang pernah kami dengar di media arus utama. Istilah “open-weight” sering disalahpahami sebagai “open source”, padahal keduanya sangat berbeda.
2. Realistis soal biaya. Episode ini tidak terjebak euforia. Angka US$40.000 dan kebutuhan memori 1 TB langsung menempatkan “AI di bawah meja” pada konteks yang benar: ini solusi untuk perusahaan, belum untuk semua orang. Secara teknis, angka ini juga masuk akal: 816 miliar parameter dengan presisi 8-bit memang membutuhkan sekitar 816 GB memori, dan empat unit 256 GB memberikan 1.024 GB.
3. Keberagaman sudut pandang. Menghadirkan pakar konsumen, peneliti AI safety, dan pakar etika teknologi dalam satu meja membuat diskusinya kaya. Penonton mendapat sisi bisnis, teknis, dan sosial sekaligus.
Yang perlu disikapi kritis
1. Judulnya lebih provokatif daripada isinya. “The end of data centres?” terdengar dramatis, padahal kesimpulan para narasumber justru sebaliknya: pusat data tidak akan hilang, dan masa depan kemungkinan besar adalah kombinasi keduanya. Model yang ditampilkan pun masih membutuhkan perangkat keras puluhan ribu dolar.
2. Diskusi melebar dari topik utama. Sepertiga terakhir episode bergeser ke risiko eksistensial AI. Topik ini penting, tetapi kurang terhubung dengan pertanyaan awal soal AI lokal versus cloud. Kami berharap ada pembahasan lebih dalam tentang hal praktis: performa model lokal dibanding model cloud, konsumsi listrik empat Mac Studio, atau model bisnis yang ditawarkan Meta dan Apple.
3. Klaim besar tanpa rincian. Pernyataan Soares tentang 1.200 agen AI yang keluar dari sandbox dan meretas Hugging Face adalah klaim yang sangat serius, tetapi disampaikan sambil lalu tanpa penjelasan sumber atau konteks. Penonton sebaiknya mencari laporan resminya sebelum menjadikannya rujukan.
4. Privasi bukan jaminan otomatis. Narasi “lokal berarti privat” ada benarnya, karena data tidak meninggalkan perangkat. Namun, model open-weight tetap merupakan “kotak hitam” yang data pelatihannya tidak dibuka. Privasi data pengguna dan transparansi model adalah dua hal yang berbeda, dan sayangnya tidak dibedakan dalam diskusi ini.
Relevansi untuk Indonesia
- Pusat data sedang tumbuh pesat di Indonesia, dari Jabodetabek hingga Batam. Pertanyaan soal pasokan listrik, air, dan lahan yang memicu penolakan di Inggris dan AS sangat mungkin akan muncul juga di sini. Pemerintah daerah dan masyarakat perlu dilibatkan sejak awal.
- Peluang bagi sektor yang sangat sensitif terhadap data. Perbankan, rumah sakit, dan instansi pemerintah yang terikat Undang-Undang Pelindungan Data Pribadi (UU PDP) bisa mempertimbangkan model open-weight yang dijalankan di server internal, sehingga data tidak keluar dari organisasi.
- Kedaulatan teknologi. Model open-weight memungkinkan perusahaan dan peneliti lokal menyesuaikan AI untuk bahasa dan konteks Indonesia tanpa bergantung sepenuhnya pada layanan cloud asing.
- Tantangan biaya. Dengan nilai tukar saat ini, investasi lebih dari Rp600 juta hanya untuk perangkat keras masih jauh dari jangkauan UMKM. Model yang lebih kecil atau layanan cloud lokal masih menjadi pilihan paling realistis untuk sebagian besar pelaku usaha.
Kesimpulan
Episode AI Decoded ini layak ditonton, terutama bagi pengambil keputusan TI dan siapa pun yang ingin memahami perdebatan “cloud versus lokal” tanpa jargon berlebihan. Penjelasannya jernih, angkanya realistis, dan sudut pandangnya beragam.
Namun, jangan terkecoh judulnya. Langkah Meta dan Apple bukanlah akhir dari pusat data, melainkan tanda bahwa AI akan hidup di dua dunia sekaligus: model raksasa di pusat data untuk kebutuhan paling berat, dan model yang lebih ringkas di perangkat kita untuk kebutuhan sehari-hari yang menuntut privasi. Pertanyaan sebenarnya bukan “cloud atau lokal”, melainkan siapa yang mengendalikan AI, dan dengan biaya sosial serta lingkungan sebesar apa.
Informasi Video
- Judul: The end of data centres? Apple and Meta’s bet against the cloud | AI Decoded
- Kanal: BBC News
- Tanggal unggah: 24 Oktober 2026
- Durasi: 15 menit 23 detik
- Tautan: youtube.com/watch?v=2Q1UG9wYgc0